Pourquoi le lazy loading peut cacher vos images à Google
Le principe est simple. Au lieu de télécharger toutes les images dès l'ouverture de la page, le navigateur ne récupère que celles qui approchent de l'écran. Sur une page longue, remplie de visuels, le gain est net, surtout en 4G. Côté vitesse, c'est l'un des réglages les plus rentables que je connaisse, pour quelques minutes de travail.
Le souci vient du robot. Googlebot n'est pas un internaute : il ne fait pas défiler la page, ne clique sur rien, ne survole aucun élément. Si votre technique de chargement différé réagit simplement à ce qui est visible dans la fenêtre, tout va bien. Si elle attend un défilement qui n'arrive jamais, vos images restent des cadres vides. Et Google indexe des cadres vides.
Google l'écrit noir sur blanc dans sa documentation sur le contenu à chargement différé : le contenu doit se charger dès qu'il devient visible dans la fenêtre d'affichage, sans dépendre d'une action comme le scroll ou le clic, parce que le moteur n'interagit pas avec la page. Tout le reste de ce guide découle de cette phrase.
La bonne méthode : l'attribut loading natif
Maintenant que tous les navigateurs modernes le gèrent, je ne vois plus beaucoup de raisons de passer par une bibliothèque JavaScript pour des images. Un attribut suffit :
<img src="/img/atelier-bois.jpg" alt="Établi de menuisier avec rabot et copeaux"
     width="1200" height="800" loading="lazy">
Ce qui compte ici, ce n'est pas tant loading="lazy" que tout le reste. Le src contient la vraie URL de l'image, directement dans le HTML envoyé par le serveur : Googlebot la lit avant même d'exécuter le moindre script. Le texte alternatif décrit ce qu'on voit, et reste votre principal levier pour Google Images. Quant aux attributs width et height, ils réservent la place à l'avance, ce qui évite que la mise en page saute quand l'image arrive (le fameux CLS des Core Web Vitals).
Le navigateur choisit seul le moment du téléchargement, avec une marge d'avance avant que l'image n'entre à l'écran. Rien à régler. Ça fonctionne aussi avec srcset et la balise picture : l'attribut se place sur l'img, les sources suivent.
Une image lazy-loadée proprement, c'est une balise img classique avec un vrai src, à laquelle on ajoute un seul attribut.
L'erreur qui coûte cher : différer l'image du haut de page
C'est ce que je croise le plus souvent en audit, et c'est assez ironique pour une optimisation censée accélérer le site. On ajoute loading="lazy" partout par réflexe, y compris sur le visuel d'en-tête ou la photo produit. Résultat : le navigateur attend d'avoir calculé la mise en page avant de demander cette image, et votre LCP, l'indicateur qui mesure l'affichage du plus gros élément visible, prend du retard. L'indexation n'est pas touchée, la vitesse perçue, si.
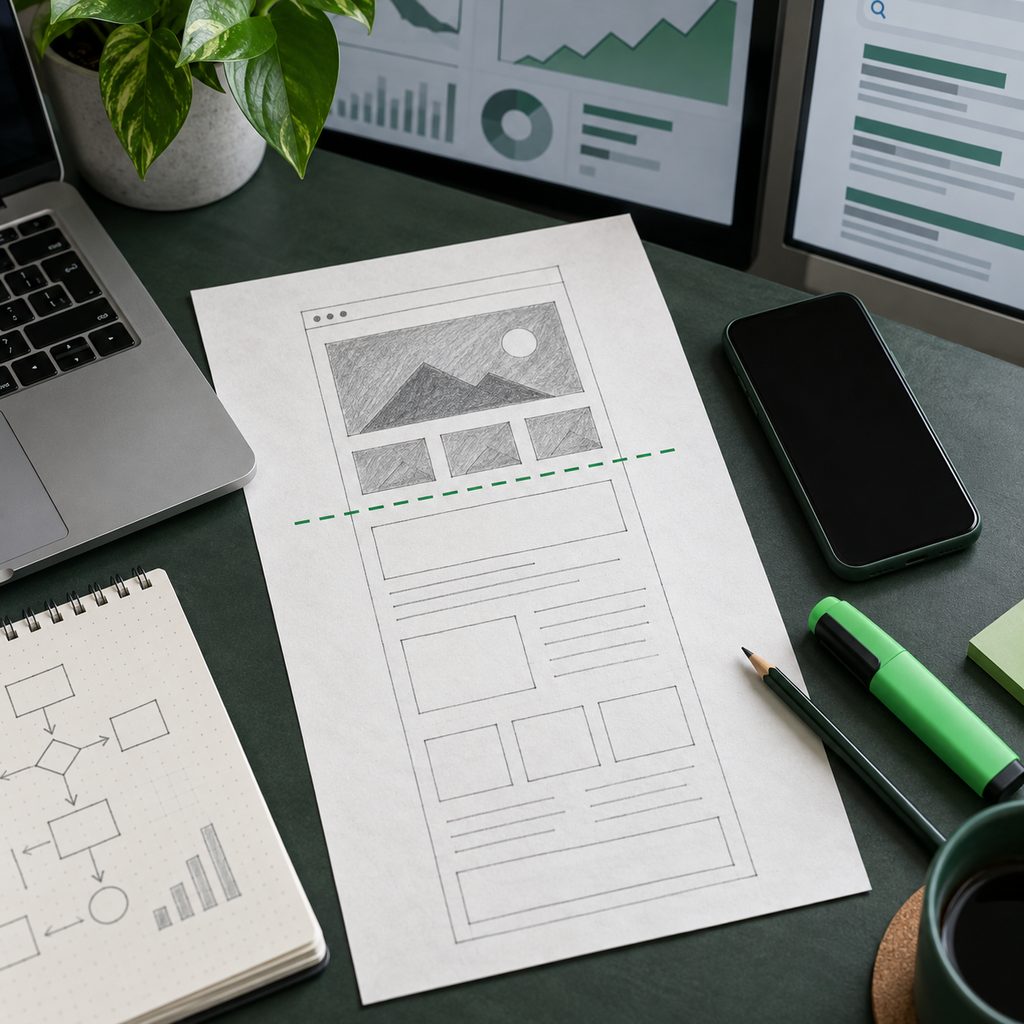
La règle est simple : tout ce qui est visible sans scroller se charge normalement, sans attribut loading. Sur l'image principale, vous pouvez même ajouter fetchpriority="high" pour qu'elle passe devant les autres ressources. Les équipes de Chrome ont documenté l'effet d'un lazy loading trop zélé dans leur analyse sur web.dev. Sous la ligne de flottaison, en revanche, lazy sans hésiter.
Attention, cette ligne n'est pas au même endroit sur un téléphone et sur un grand écran. Dans le doute, je laisse en chargement normal la ou les premières images qui ont une chance réelle d'apparaître d'entrée sur l'un des deux formats.
Scripts maison et vieilles bibliothèques : là où ça casse
Avant l'attribut natif, tout le monde passait par du JavaScript, et beaucoup de sites tournent encore comme ça. Le montage classique : une image de remplacement dans le src (un pixel transparent, un aplat gris), la vraie adresse rangée dans un data-src, et un script qui fait l'échange au bon moment.
Ce n'est pas forcément un problème. Tout dépend de ce qui déclenche l'échange :
- IntersectionObserver, l'API qui détecte qu'un élément entre dans la fenêtre : Google la cite lui-même parmi les méthodes compatibles.
- L'événement scroll : risqué. Le robot ne fait pas défiler la page, l'événement peut ne jamais se produire, et l'image reste un pixel transparent.
- Un clic, un survol, un bouton « voir plus » : invisible pour Google. Il n'appuie sur rien.
On retrouve un principe plus large, que j'ai détaillé en décortiquant ce que Google voit réellement d'un site qui repose sur JavaScript : le robot prend une photo de la page rendue, sans la toucher. Si l'image n'est pas dans cette photo, elle n'existe pas pour lui.
Un piège annexe, moins connu : le script de lazy loading bloqué par le robots.txt. Si Google ne peut pas télécharger le fichier JavaScript, il ne l'exécute pas, et vos data-src ne seront jamais convertis. Même punition si le dossier des images est interdit d'exploration. Un coup d'œil à vos fichiers robots.txt et sitemap XML, qui pilotent l'exploration du site règle la question en deux minutes.
Vérifier ce que Googlebot voit vraiment
Ne vous fiez pas à votre navigateur : vous, vous scrollez. Trois contrôles, du plus rapide au plus poussé :
- Dans la Search Console, inspectez l'URL, lancez « Tester l'URL en ligne » puis « Afficher la page testée ». Dans l'onglet HTML, cherchez vos balises img : le src doit contenir la vraie adresse, pas un pixel de remplacement.
- La capture d'écran du même test montre la page telle que le robot l'a rendue. Des blocs gris à la place des photos, c'est le signe d'un chargement qui attend une action.
- Sur un site riche en images, les logs tranchent : ils montrent si Googlebot-Image vient réellement chercher vos fichiers. J'explique la démarche dans mon guide pour analyser les logs de votre serveur avec un regard SEO.
Gardez aussi en tête qu'une image fraîchement publiée met du temps à apparaître dans Google Images, même quand tout est propre. Si le HTML rendu contient les bonnes URL, patientez plutôt que de tout recoder.
Et sur WordPress ?
Bonne nouvelle : WordPress ajoute lui-même loading="lazy" aux images de vos contenus, et ce depuis plusieurs années. Les versions récentes essaient même d'épargner la première image de la page. Sur un site à jour, sans extension exotique, il n'y a souvent rien à faire.
Le vrai risque, ce sont les empilements. Un thème qui a son propre système, une extension de performance qui en ajoute un deuxième, un constructeur de pages qui passe les visuels en arrière-plan CSS : chacun réécrit le HTML à sa manière. Quand je récupère un WordPress lent, je commence par couper tous les lazy loading tiers, je laisse faire le natif, puis je repasse le test d'inspection d'URL. Le plus souvent, ça suffit.