rel next/prev ignoré : qu'est-ce qui a changé, concrètement ?
En mars 2019, Google a reconnu publiquement qu'il n'utilisait plus les balises rel="next" et rel="prev" depuis plusieurs années. Beaucoup de gérants de boutique l'ont appris en même temps que leur agence, et la question a suivi dans la foulée : si Google ne sait plus que la page 3 fait partie d'une série, on en fait quoi ?
Réponse courte : rien de spécial. Et c'est justement ça, le changement. Google traite chaque page paginée comme une page indépendante : il l'explore, lit ses liens, et décide seul de l'indexer ou non. Sa documentation sur la pagination et le chargement progressif le dit sans détour, les URL d'une séquence paginée sont considérées comme des pages distinctes. Pas de regroupement automatique, pas de consolidation magique vers la page 1.
Faut-il retirer ces balises de votre thème ? Pas la peine. Elles ne gênent rien, et Google précise que d'autres moteurs peuvent encore s'en servir. Ne comptez simplement plus sur elles côté Google.
Une URL propre et une canonical qui pointe vers elle-même
Chaque page de la série a besoin de sa propre adresse, présente dans le HTML. Un paramètre ?page=2 (le format de Shopify) ou un chemin /page/2/ (celui de WooCommerce) font très bien l'affaire. Ce qui ne marche pas, c'est le fragment : #page=2. Google ignore tout ce qui suit le dièse, donc pour lui vos pages 2, 3 et 4 n'existent pas.
Ensuite, la balise canonical. Sur chaque page paginée, elle pointe vers la page elle-même :
<!-- sur /collections/chaussures-running?page=3 -->
<link rel="canonical" href="https://www.maboutique.fr/collections/chaussures-running?page=3">
J'insiste parce que l'erreur inverse est partout : une canonical de la page 3 vers la page 1. L'intention paraît logique (« c'est la page 1 que je veux positionner »), sauf qu'elle raconte à Google que la page 3 est un doublon de la page 1. Or elle n'affiche pas les mêmes produits. Au mieux, Google ignore votre indication. Au pire, il vous croit, se désintéresse des pages suivantes, et les produits qu'on ne trouve qu'en page 3 perdent leur principal chemin d'accès. Si le mécanisme vous paraît flou, j'ai détaillé à quoi sert vraiment une balise canonical et la façon dont Google la traite.
Un détail qui traîne sur beaucoup de boutiques : l'URL ?page=1, qui duplique la catégorie de base. Vos liens « page 1 » doivent viser l'URL sans paramètre, et si ?page=1 circule déjà, une redirection 301 vers la catégorie règle la question.
Des liens HTML entre les pages, même derrière le bouton « voir plus »
Googlebot suit des liens, pas des boutons. Chaque page doit donc contenir de vraies balises <a href> vers la page suivante, idéalement vers la précédente, et vers la première page de la série : Google recommande explicitement ce lien de retour au début. Le bon vieux bloc de pagination « 1 2 3 … 12 » coche toutes les cases.
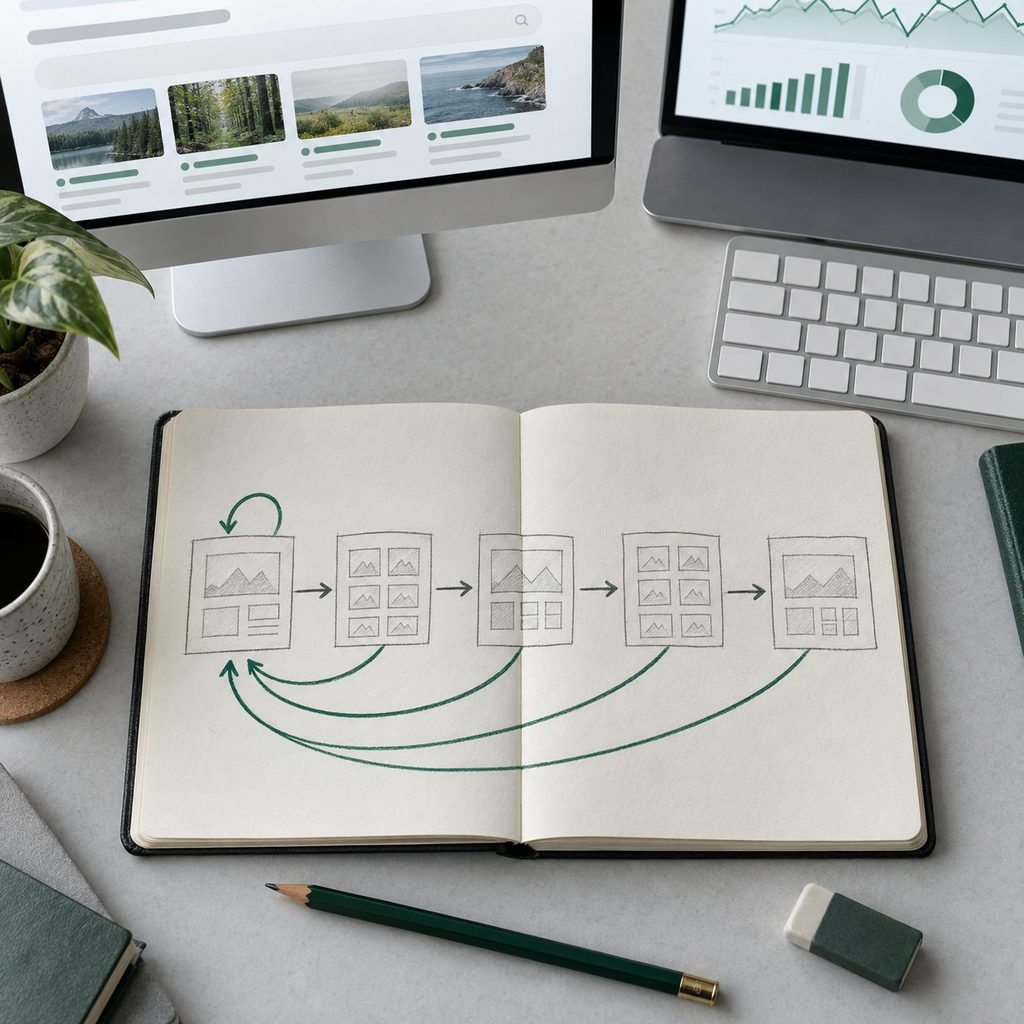
Le vrai piège, c'est le bouton « Charger plus de produits » et le défilement infini. Ils reposent presque toujours sur du JavaScript, et Google indique que ses robots ne déclenchent généralement pas les actions qui demandent une interaction de l'utilisateur. Traduction : tout ce qui apparaît après le clic reste invisible pour lui.
La parade que j'installe à chaque fois, c'est l'amélioration progressive. Le bouton est un vrai lien vers ?page=2, et le JavaScript intercepte le clic pour afficher les produits sans recharger la page. L'internaute a son chargement fluide, le robot a son lien. Pour le défilement infini, même logique : chaque tranche de produits correspond à une URL paginée accessible directement, et l'adresse dans la barre du navigateur évolue au fil du scroll.
Ce que je retire systématiquement en audit
- La canonical de toutes les pages paginées vers la page 1. On vient de voir pourquoi.
- Le noindex sur les pages 2 et suivantes. À court terme, Google continue de suivre leurs liens. Mais John Mueller, chez Google, a expliqué qu'une page gardée longtemps en noindex finit par être explorée moins souvent, et que ses liens peuvent alors ne plus être suivis. Sur une catégorie profonde, c'est l'inverse de l'effet recherché.
- Le blocage de
?page=dans le robots.txt. Là, c'est radical : Googlebot n'entre plus dans les pages 2 et suivantes, donc plus dans les produits qu'elles listent. - Le texte de catégorie recopié sur toute la série. Je le garde sur la page 1 uniquement, puisque c'est elle qui doit se positionner.
Ces deux directives ont leur utilité, juste pas ici. Pour savoir que choisir entre noindex et robots.txt selon la situation, j'ai consacré un article entier à la question.
Une pagination bien gérée ne cherche pas à se classer : c'est un couloir vers vos fiches produits, et un couloir, ça doit rester ouvert.
Tri et filtres : là où la pagination explose
Seule, la pagination reste raisonnable : une catégorie de 300 produits affichés par 30, ça fait dix URL. Le problème arrive quand elle se combine au tri et aux filtres. Prix croissant, nouveautés, pointure 42, coloris noir… Chaque combinaison crée sa propre série paginée, et le nombre d'URL grimpe très vite, sans aucune recherche Google derrière la plupart d'entre elles.
C'est là, et seulement là, que le noindex ou le robots.txt entrent en jeu, comme Google le conseille pour les tris et filtres indésirables. La pagination de la catégorie « nue » reste ouverte, les variantes triées sont écartées. Sur un gros catalogue, c'est typiquement la situation où optimiser son budget de crawl devient rentable : Googlebot arrête de tourner en rond dans des milliers de combinaisons.
Moins de pages à parcourir, c'est souvent la vraie solution
Une fois la technique propre, posez-vous une question plus terre à terre : pourquoi vos produits sont-ils enfouis en page 8 ? Dans les logs serveur, le constat revient souvent : plus on s'enfonce dans une série paginée, plus les passages de Googlebot s'espacent.
Trois leviers, du plus simple au plus structurant :
- Afficher plus de produits par page (passer de 24 à 48, par exemple), tant que la vitesse de chargement suit.
- Découper les catégories trop larges en sous-catégories, qui ont en prime une chance de se positionner sur leur propre requête.
- Faire remonter les produits qui comptent par des liens depuis la page 1, les fiches voisines ou vos contenus éditoriaux.
Le sitemap XML aide Google à découvrir vos fiches produits, mais il ne remplace pas ces liens. Il signale qu'une page existe, pas qu'elle a de l'importance.
Vérifier votre pagination en dix minutes
Ouvrez une page 3 de catégorie et affichez le code source brut (Ctrl+U, pas l'inspecteur). Cherchez deux choses : une canonical qui reprend l'URL de cette page 3, et des liens de pagination sous forme de balises a avec un href complet. S'ils n'y sont pas, passez l'URL dans l'outil d'inspection de la Search Console pour voir ce que Google obtient après rendu.
Tapez ensuite une adresse absurde, comme ?page=999. Si la boutique affiche une page vide avec un code 200, c'est une soft 404 : elle devrait répondre 404. Enfin, un crawl avec Screaming Frog (gratuit jusqu'à 500 URL) montre d'un coup d'œil jusqu'où descendent vos séries et combien d'URL de tri traînent dans la nature. C'est souvent là que se cachent les surprises.